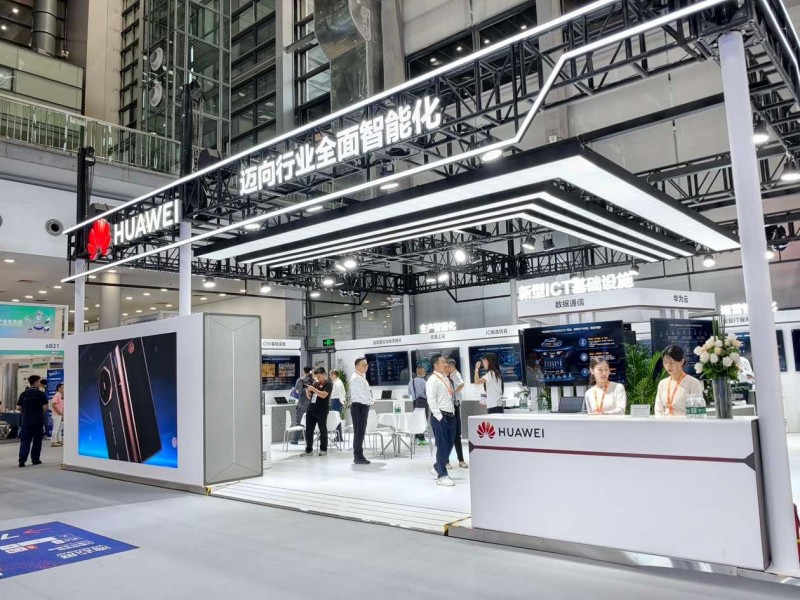
在2026湾芯展华为展台,“迈向行业全面智能化”的主题并莫得停留在大模子或算力芯片的单点展示。OceanStor A800高性能AI存储、企业级AI Coding决策、鲲鹏920新式号工作器以及面向EDA、OPC的HPCKit,被放在归拢条叙事线上。它们分辩对应AI期间常被低估的几件事:数据能否高效喂给算力,模子能否在企业内安全启动,芯片假想软件能否在底层野心平台上赢得相识加快。
AI基础法式 先把数据路买通
大模子训诫与推理的瓶颈,越来越不单在算力卡自身。模子参数、训诫语料和推理经过中的KV Cache齐在捏续拉高数据隐约需求。现场展示的OceanStor A800,恰是围绕这一问题张开。其通过NDS纵贯NPU,试图裁减数据从存储到野心侧的旅途,减少复杂公约栈与数据拷贝;华为给出的现场云尔清楚,这一决策可带来40%的性能擢升。
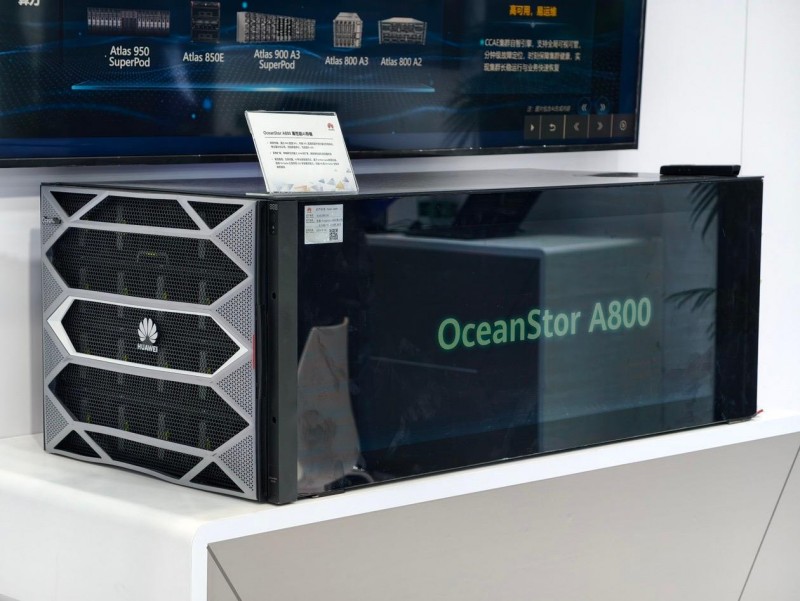
A800的另一层要点是推理阶段。它支捏向量、KV等数据范式,并以Unified Cache买通从显存到SSD的多层缓存能力,想法是把KV Cache作念成可分享的PB级资源池。单集群最大支捏2048控扩张,则陈说了训诫、推理集群扩大后对性能和容量密度的双伏击求。对企业而言,AI基础法式的竞争照旧从“有莫得算力”蔓延到“数据能否跟上算力”。
AI Coding 让企业把智能编码留在土产货
在AI Coding决策中,华为给出的架构分为Agent、模子与算力三层。表层可接入OpenCode、Z Code、合见UDA及自研Agent,面向镶嵌式软件、企业IT、CI/CD和芯片假想等场景;模子层兼容DeepSeek、通义千问、Kimi、智谱等主流模子;底层则由Atlas 950 SuperPod、Atlas 850E、Atlas 900 A3 SuperPod、Atlas 800 A3与Atlas 800 A2等算力平台相沿。
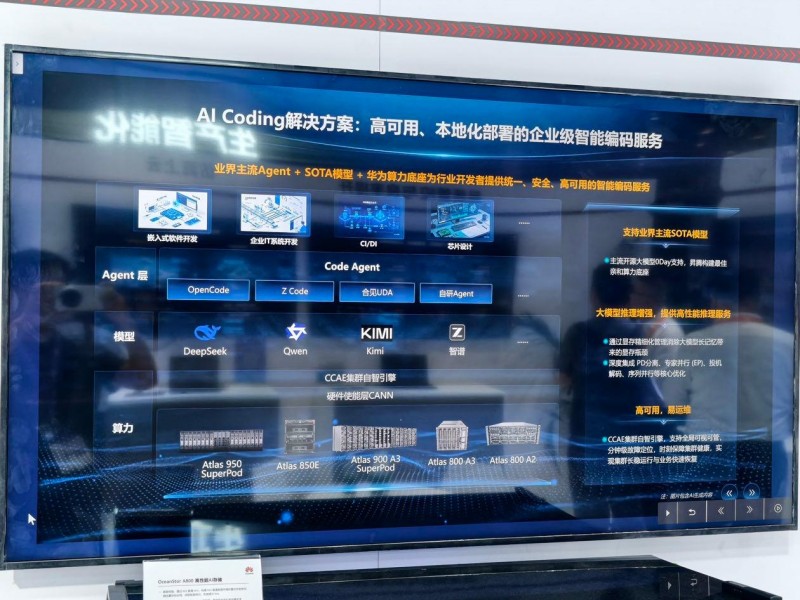
这套决策思科罚的并非“让代码自动补全”这样轻便,而是让企业在土产货化环境中赢得可管束的智能编码工作。靠近长荆棘文和复杂工程,显存管束、PD分离、行家并行、投契解码和序列并行等优化径直影响推理成果;而集群层的可视可管、故障定位和快速规复,决定了决策能否着实参加坐褥系统。模子能力独揽趋同之后,部署、运维与数据鸿沟,正在成为企业汲取AI Coding决策的新门槛。
鲲鹏通算与EDA软件栈 一次面向假想步地的加快
展台另一条干线落在芯片假想基础法式。鲲鹏920新式号工作器搭载两颗鲲鹏920处理器,支捏32条DDR5 DIMM、最高4TB内存,并提供面向不同存储需求的2.5英寸或3.5英寸盘位决策。它所工作的并不仅是通用工作器商场,也为EDA仿真、野心光刻等对内存容量、并行能力和相识性更敏锐的负载提供底座。
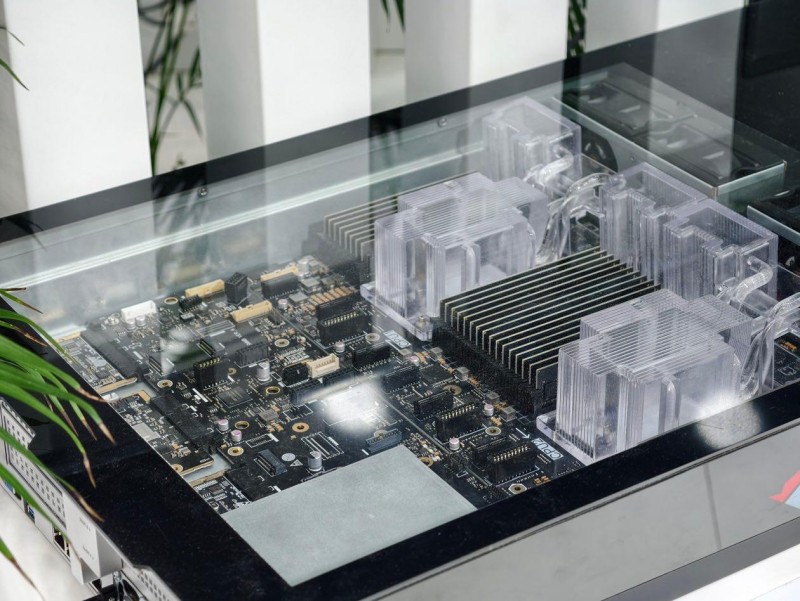
与硬件配套的HPCKit,则把优化下千里到数学库、并行库、编译器、操作系统和鲲鹏硬件平台。现场展板清楚,天元寥落径直法求解器对比x86 SPR+Pardiso端到端性能跨越90%以上,KuLitho野心光刻库可助力OPC诈欺性能擢升50%以上;KUPL与毕昇编译器也分辩给出10%以上的擢升计算。这些数字需要在不同工艺、数据鸿沟和诈欺版块中陆续考据,但标的已很显明:在EDA这类高门槛软件场景里,芯片、工作器和基础软件必须沿途作念优化,单靠硬件替换很难赢得好意思满收益。
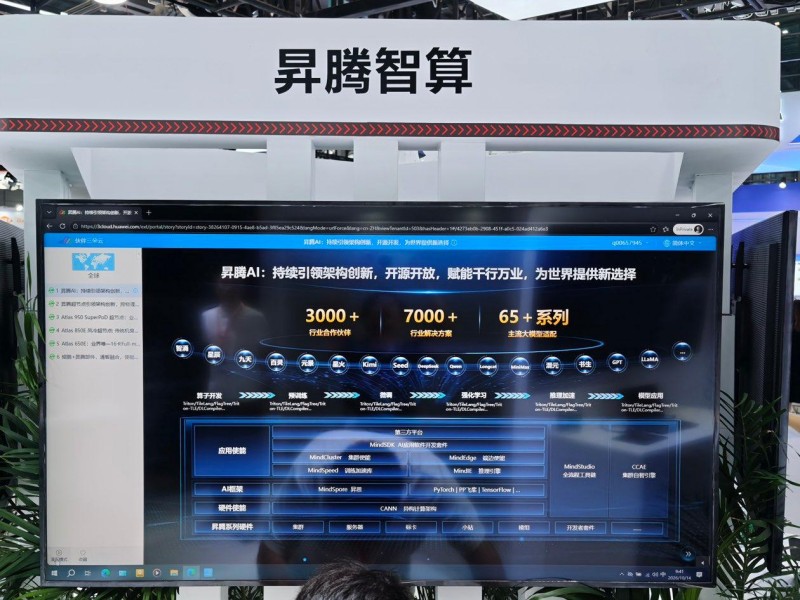
热门科技瞻念察:华为在湾芯展呈现的,不是一组彼此孤苦的家具赌钱网官网,而是一条从AI数据、算力疏导、企业级诈欺,到芯片假想野心的底层能力链。半导体与AI产业参加深水区后,单一确立或单一模子已很难科罚真的坐褥问题。能否把存储、算力、软件栈和运维体系协同起来,才决定了决策能否从展台走进企业与工场。